一篇很老的论文,Model‑Agnostic Meta‑Learning for Fast Adaptation of Deep Networks (2017)。
但是思想非常有意思,其学习的不是一个直接用于预测的模型,而是学习“如何更快更好地学习一个模型”。
MAML 学习一个好的初始化权重,从而在新任务上实现 fast adaptation,即在小规模的训练样本上迅速收敛并完成 fine‑tune。model‑agnostic 即 模型无关。MAML 与其说是一个深度学习模型,倒不如说是一个框架,提供一个 meta‑learn 来训练 base‑learn
擅长解决的问题:N‑way K‑shot
MAML 算法训练的模型,不一定擅长任务,但是基于他训练的模型会更简单更快的达到预期。(预训练方法的模型本身就具有一定的性能)
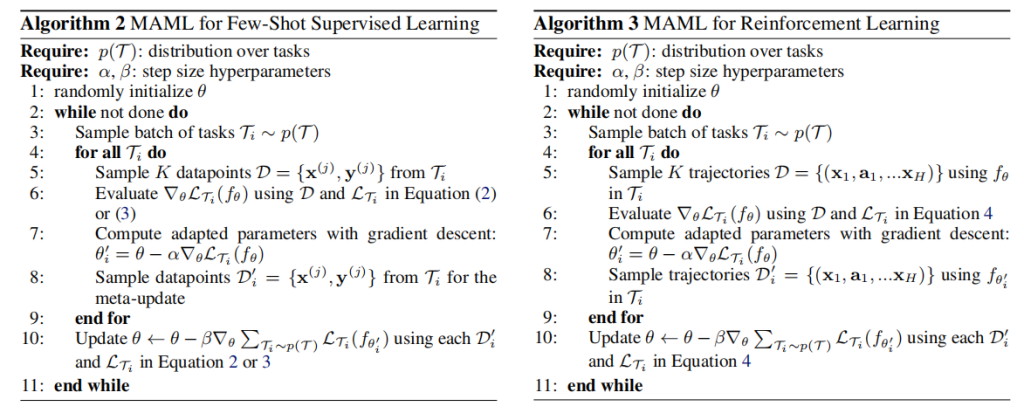
训练的核心思路是从任务池 p(Ti) 中抽取一部分 Ti 来训练模型,但是内层梯度不用来更新 Mmeta(目标模型);最后用子任务训练出的模型在测试集上的梯度(这个应该算外层)更新 Mmeta
大概是这样:
- 任务池采样:从任务分布 p(Ti) 中采样出若干个任务(比如 Ti)
- 内层梯度:对于每个子任务 Ti,我们从元模型 Mmeta 参数为 θ 复制出一个副本,让这个副本在子任务 Ti 的支持集上跑几次梯度下降,得到专属参数 θi
注意:这个过程确实完全不修改原始的 θ - 外层梯度:用这个训练好的副本 θi 去该子任务 Ti 的查询集(Query Set)上测试,算出损失。然后用这个损失 对原始的 θ 求导,用这个导数来更新 Mmeta
总之就是你教出来的模型怎么学习不归你管,但是你教的模型训练出的结果要作为你的新的教学思路。